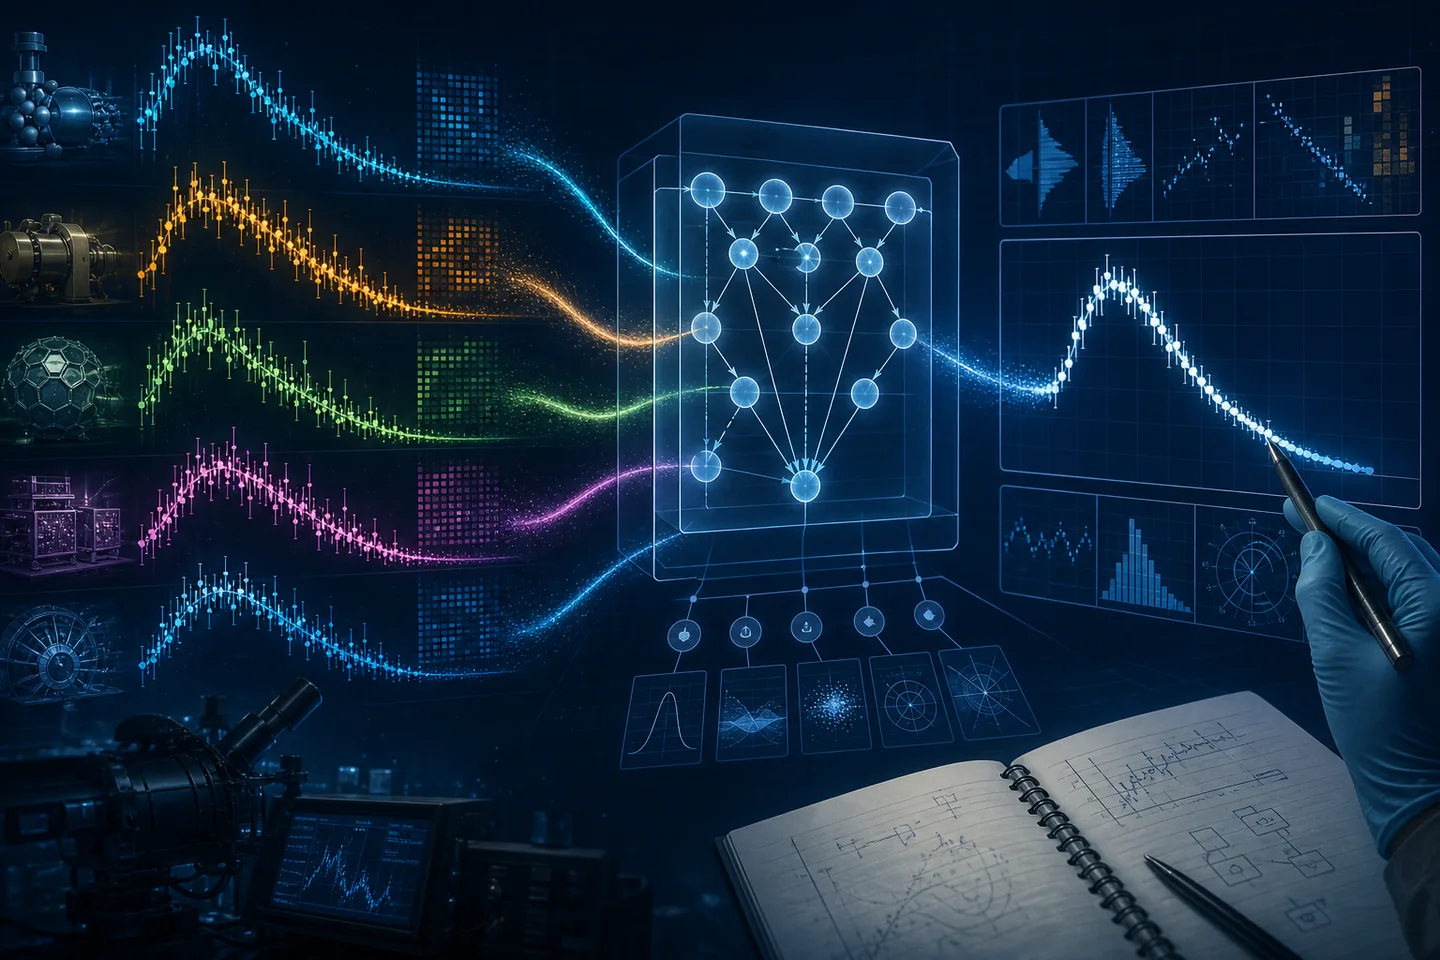
Verschiedene Labore messen mitunter dieselbe Größe unterschiedlich, obwohl jedes Experiment überzeugend erscheint. Ein Team aus Los Alamos, NIST und Brookhaven entwickelte deshalb einen Ablauf, der das Urteil nicht einem Algorithmus überlässt. Bayessches maschinelles Lernen hebt vielmehr wenige verdächtige Merkmale aus umfangreichen Metadaten historischer Verfahren hervor.
Demonstriert wurde das Verfahren am Energiespektrum von Neutronen, die weniger als eine Nanosekunde nach der spontanen Spaltung von Californium-252 freigesetzt werden — einem wichtigen Standard der Kernphysik. Das Modell verband Abweichungen mit Aufbau und Ablauf; Physiker prüften mögliche Ursachen anschließend durch Simulation alter Apparaturen oder moderne Experimente.
Erst diese menschliche und experimentelle Kontrolle erlaubte es, historische Daten physikalisch begründet zu korrigieren oder zu verwerfen. Die Streuung der Spektren verringerte sich um bis zu Faktor sechs. Das gilt für diesen Fall und nicht für eine allgemeine Fähigkeit der KI, wissenschaftliche Literatur automatisch zu reparieren.
Übertragbar wäre der Ansatz für Metrologie, Materialforschung, Chemie oder medizinische Messtechnik, wenn ältere Daten teuer oder nicht wiederholbar sind. Sein realistischer Nutzen läge nicht in der Wahl eines Siegers, sondern in einer Rangfolge möglicher systematischer Fehler, damit Fachleute die aussagekräftigsten Kontrollversuche priorisieren.
Nötig sind hochwertige vergleichbare Metadaten, physikalisch plausible Simulationen, unabhängige Wiederholungen und Schutz vor nachträglich passend gemachten Erklärungen. Optimistisch sind in 2–4 Jahren Demonstrationen in weiteren Fachgebieten und in 5–8 Jahren spezialisierte Werkzeuge denkbar. Datenbanken ohne Expertenprüfung automatisch umzuschreiben wäre nicht vertrauenswürdig.
Eröffnen Sie die Diskussion mit dem ersten Kommentar.