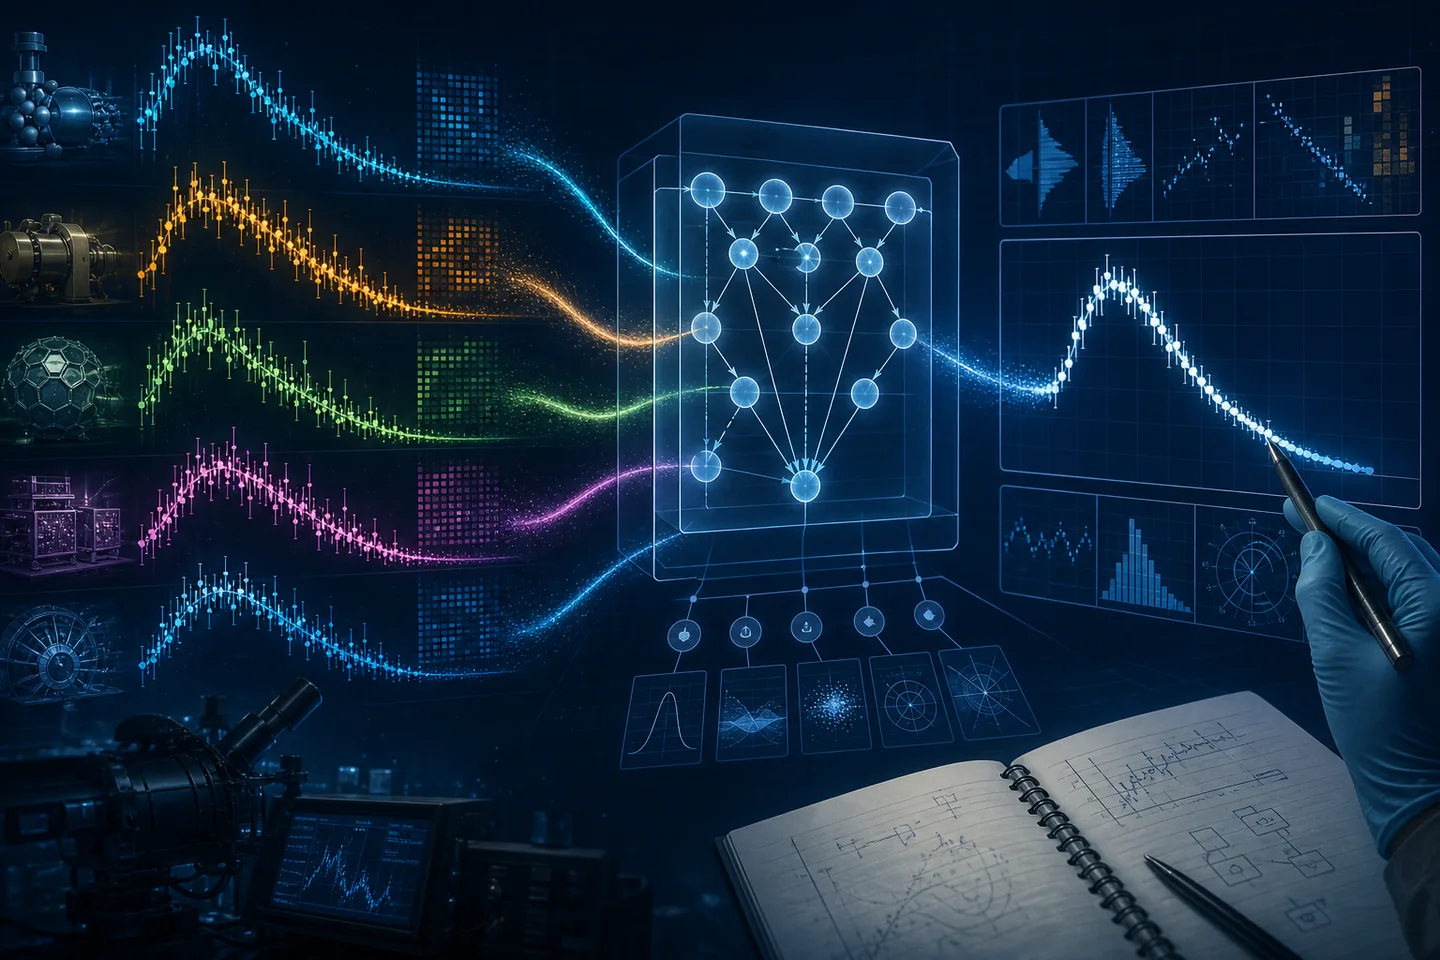
Laboratori diversi talvolta misurano valori differenti della stessa grandezza, anche quando ogni esperimento appare convincente. Un gruppo di Los Alamos, NIST e Brookhaven ha quindi creato un processo che non affida il giudizio all’algoritmo: l’apprendimento bayesiano evidenzia pochi elementi sospetti tra molti metadati sulle procedure storiche.
La dimostrazione riguarda lo spettro energetico dei neutroni liberati in meno di un nanosecondo dalla fissione spontanea del californio-252, importante standard di fisica nucleare. Il modello ha collegato le divergenze a progetto e procedura; i fisici hanno poi verificato le cause simulando apparati storici o progettando esperimenti moderni.
Solo questo controllo umano e sperimentale ha permesso di correggere o respingere dati storici su basi fisiche. La dispersione fra gli spettri è diminuita fino a un fattore sei. Il dato riguarda questo caso specifico, non una capacità generale dell’IA di riparare automaticamente la letteratura scientifica.
Se trasferibile, il metodo potrebbe aiutare metrologia, materiali, chimica o misure mediche quando i dati storici sono costosi o impossibili da ripetere. Il valore realistico non sarebbe scegliere il risultato vincente, ma ordinare le possibili fonti di errore sistematico e concentrare il tempo degli esperti sui controlli più informativi.
Servono metadati ricchi e confrontabili, simulazioni fisicamente credibili, repliche indipendenti e regole contro spiegazioni adattate a posteriori. In modo ottimistico, dimostrazioni in altri settori potrebbero arrivare in 2–4 anni e strumenti specialistici pratici in 5–8 anni. Correggere banche dati senza revisione esperta non sarebbe affidabile.
Apri la discussione con il primo commento.